Hallo zusammen! Ich habe mich entschieden, in NLP (Natural Language Processing) einzusteigen und habe für mein erstes Projekt einen Datensatz mit echten und erfundenen Nachrichten gefunden. Mein Ziel war es, ein Modell zu trainieren, das Falschmeldungen von echten Nachrichten unterscheiden kann.
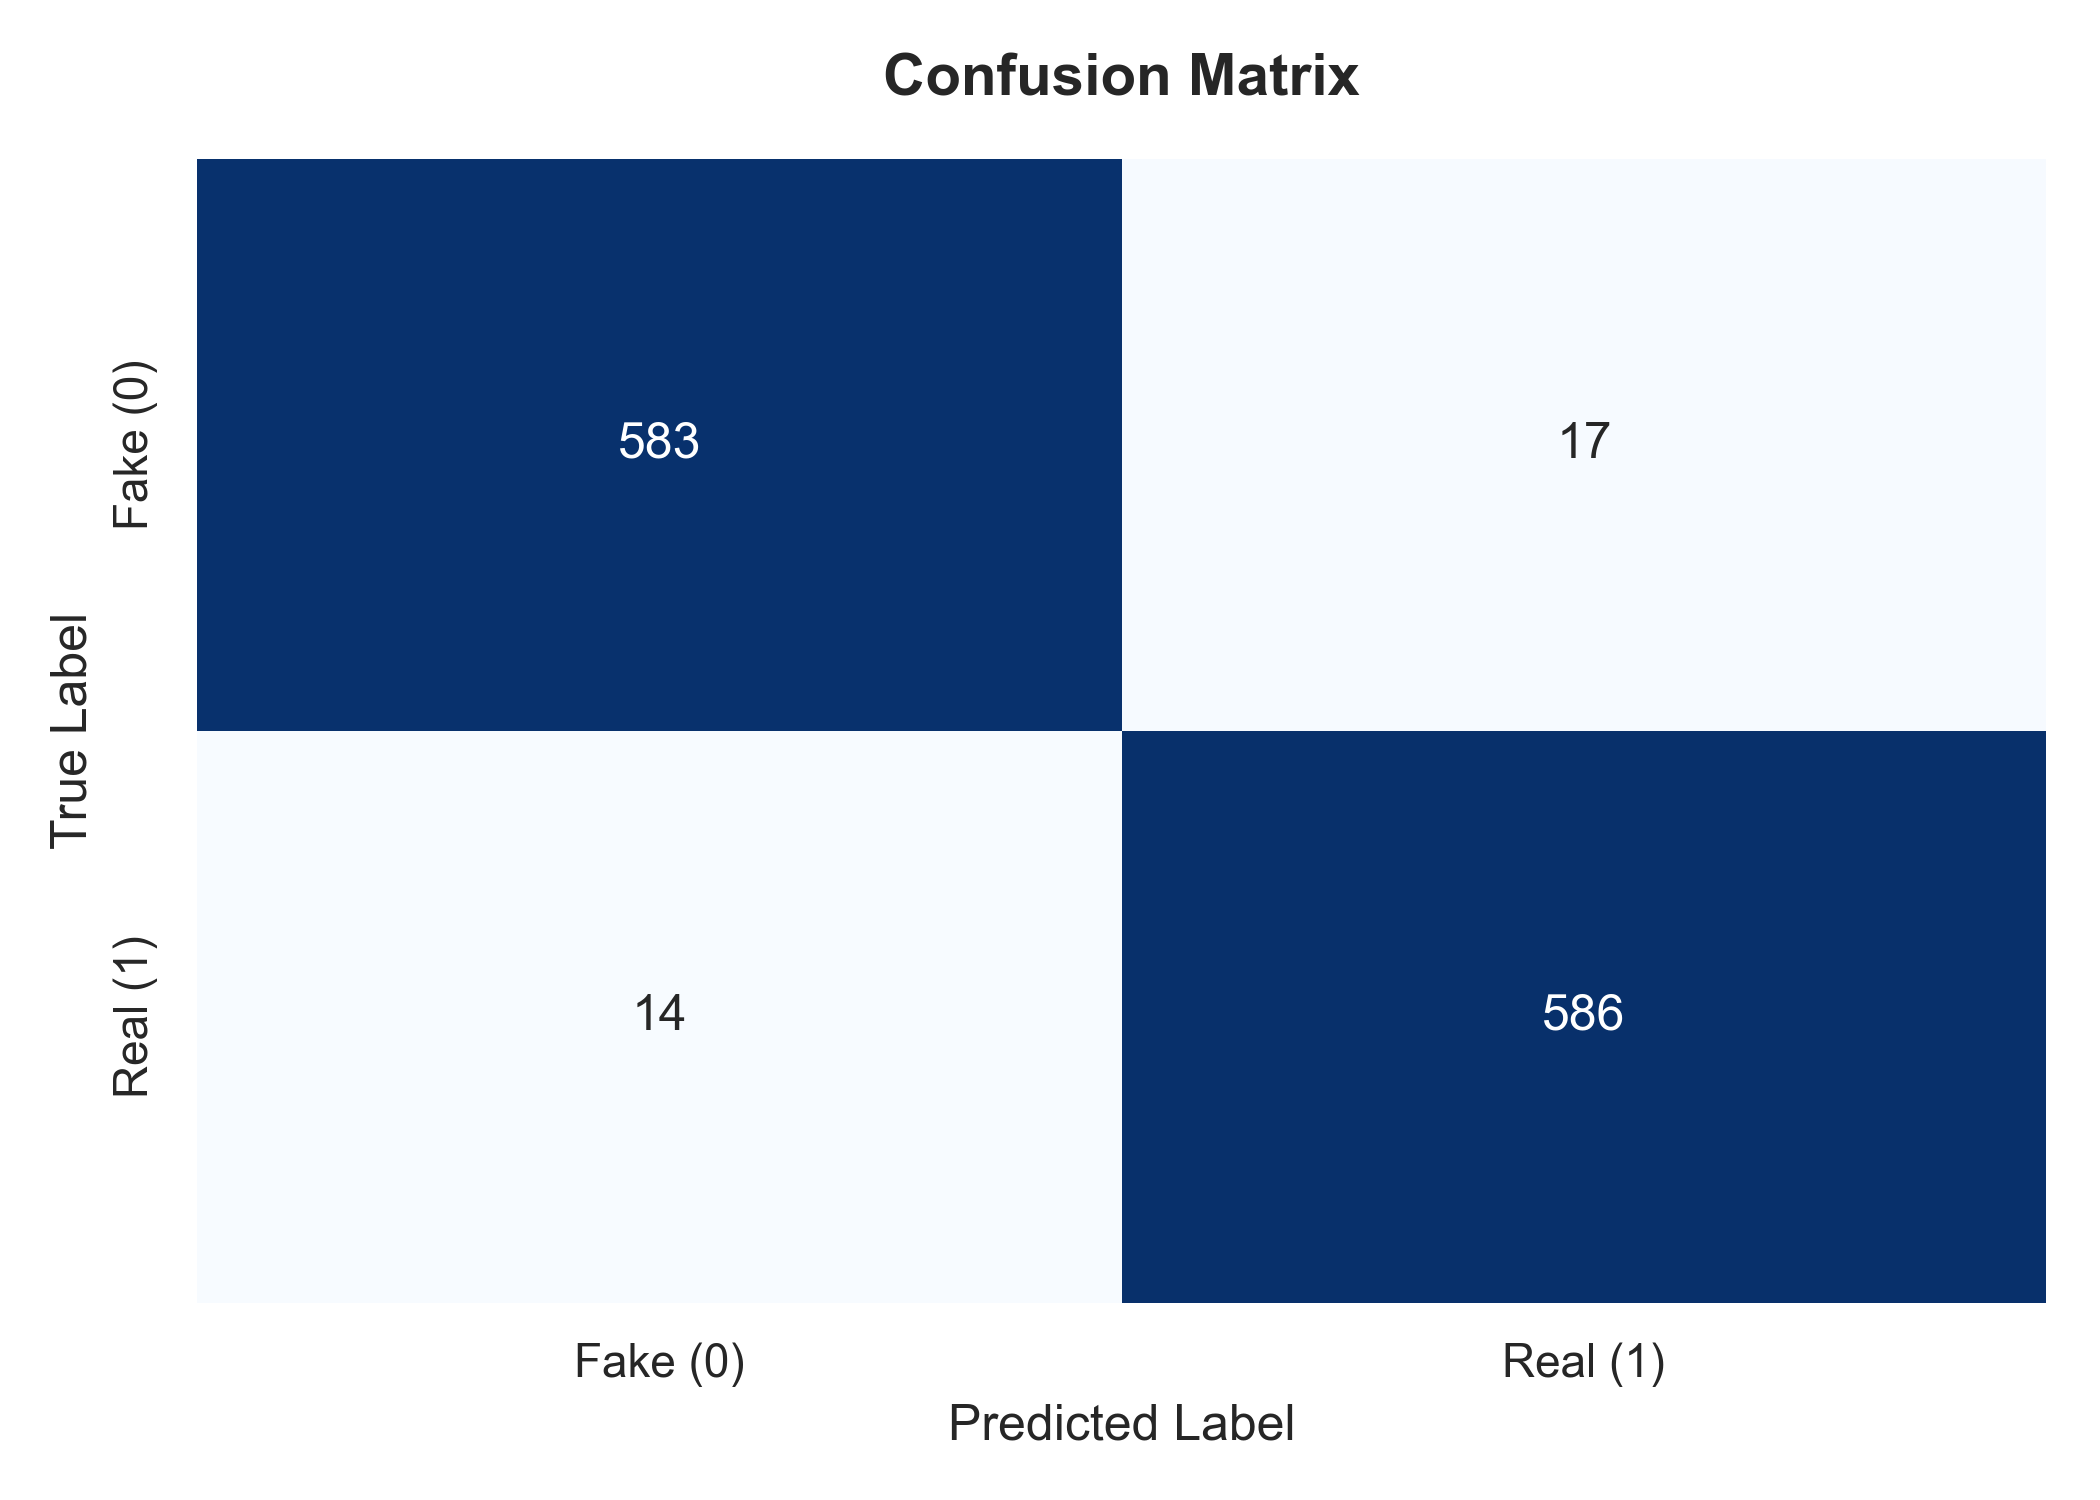
Für die Umsetzung habe ich eine Kombination aus TF-IDF Vectorizer und Logistic Regression aus der scikit-learn Bibliothek verwendet. Auf dem Testdatensatz erreichte das Modell eine beeindruckende Genauigkeit von 97,25 %. Richtig interessant wurde es jedoch, als dieselbe erfundene Nachricht auf vier verschiedene Arten formuliert wurde:
“BREAKING: Germany Bans Smartphones in All Schools and Universities Starting 2027” → Real
“Germany to Introduce Nationwide Smartphone Ban in Schools and Universities in 2027” → Real
“Federal Government Announces New Restrictions on Smartphone Use Across German Education System” → Real
“Germany Plans to Eliminate Personal Smartphone Use in Educational Institutions Starting in 2027” → Fake
🖼️ confusion_matrix.png
Beachten Sie: Trotz der hohen Genauigkeit bleibt das Modell anfällig. Seine Entscheidung wird stark von Schlüsselwörtern und dem Schreibstil beeinflusst:
„BREAKING“ und „Nationwide“ ähneln dem Stil von Eilmeldungen.
„Federal Government Announces“ klingt wie eine offizielle Pressemitteilung.
„Plans to Eliminate“ nutzt Wortkombinationen, die im Trainingsdatensatz häufiger bei Falschmeldungen vorkamen.
Dadruch bewertet der Klassifikator lediglich den Schreibstil und Wortkombinationen, während tatsächliche Fakten, Zahlen oder Daten ignoriert werden.
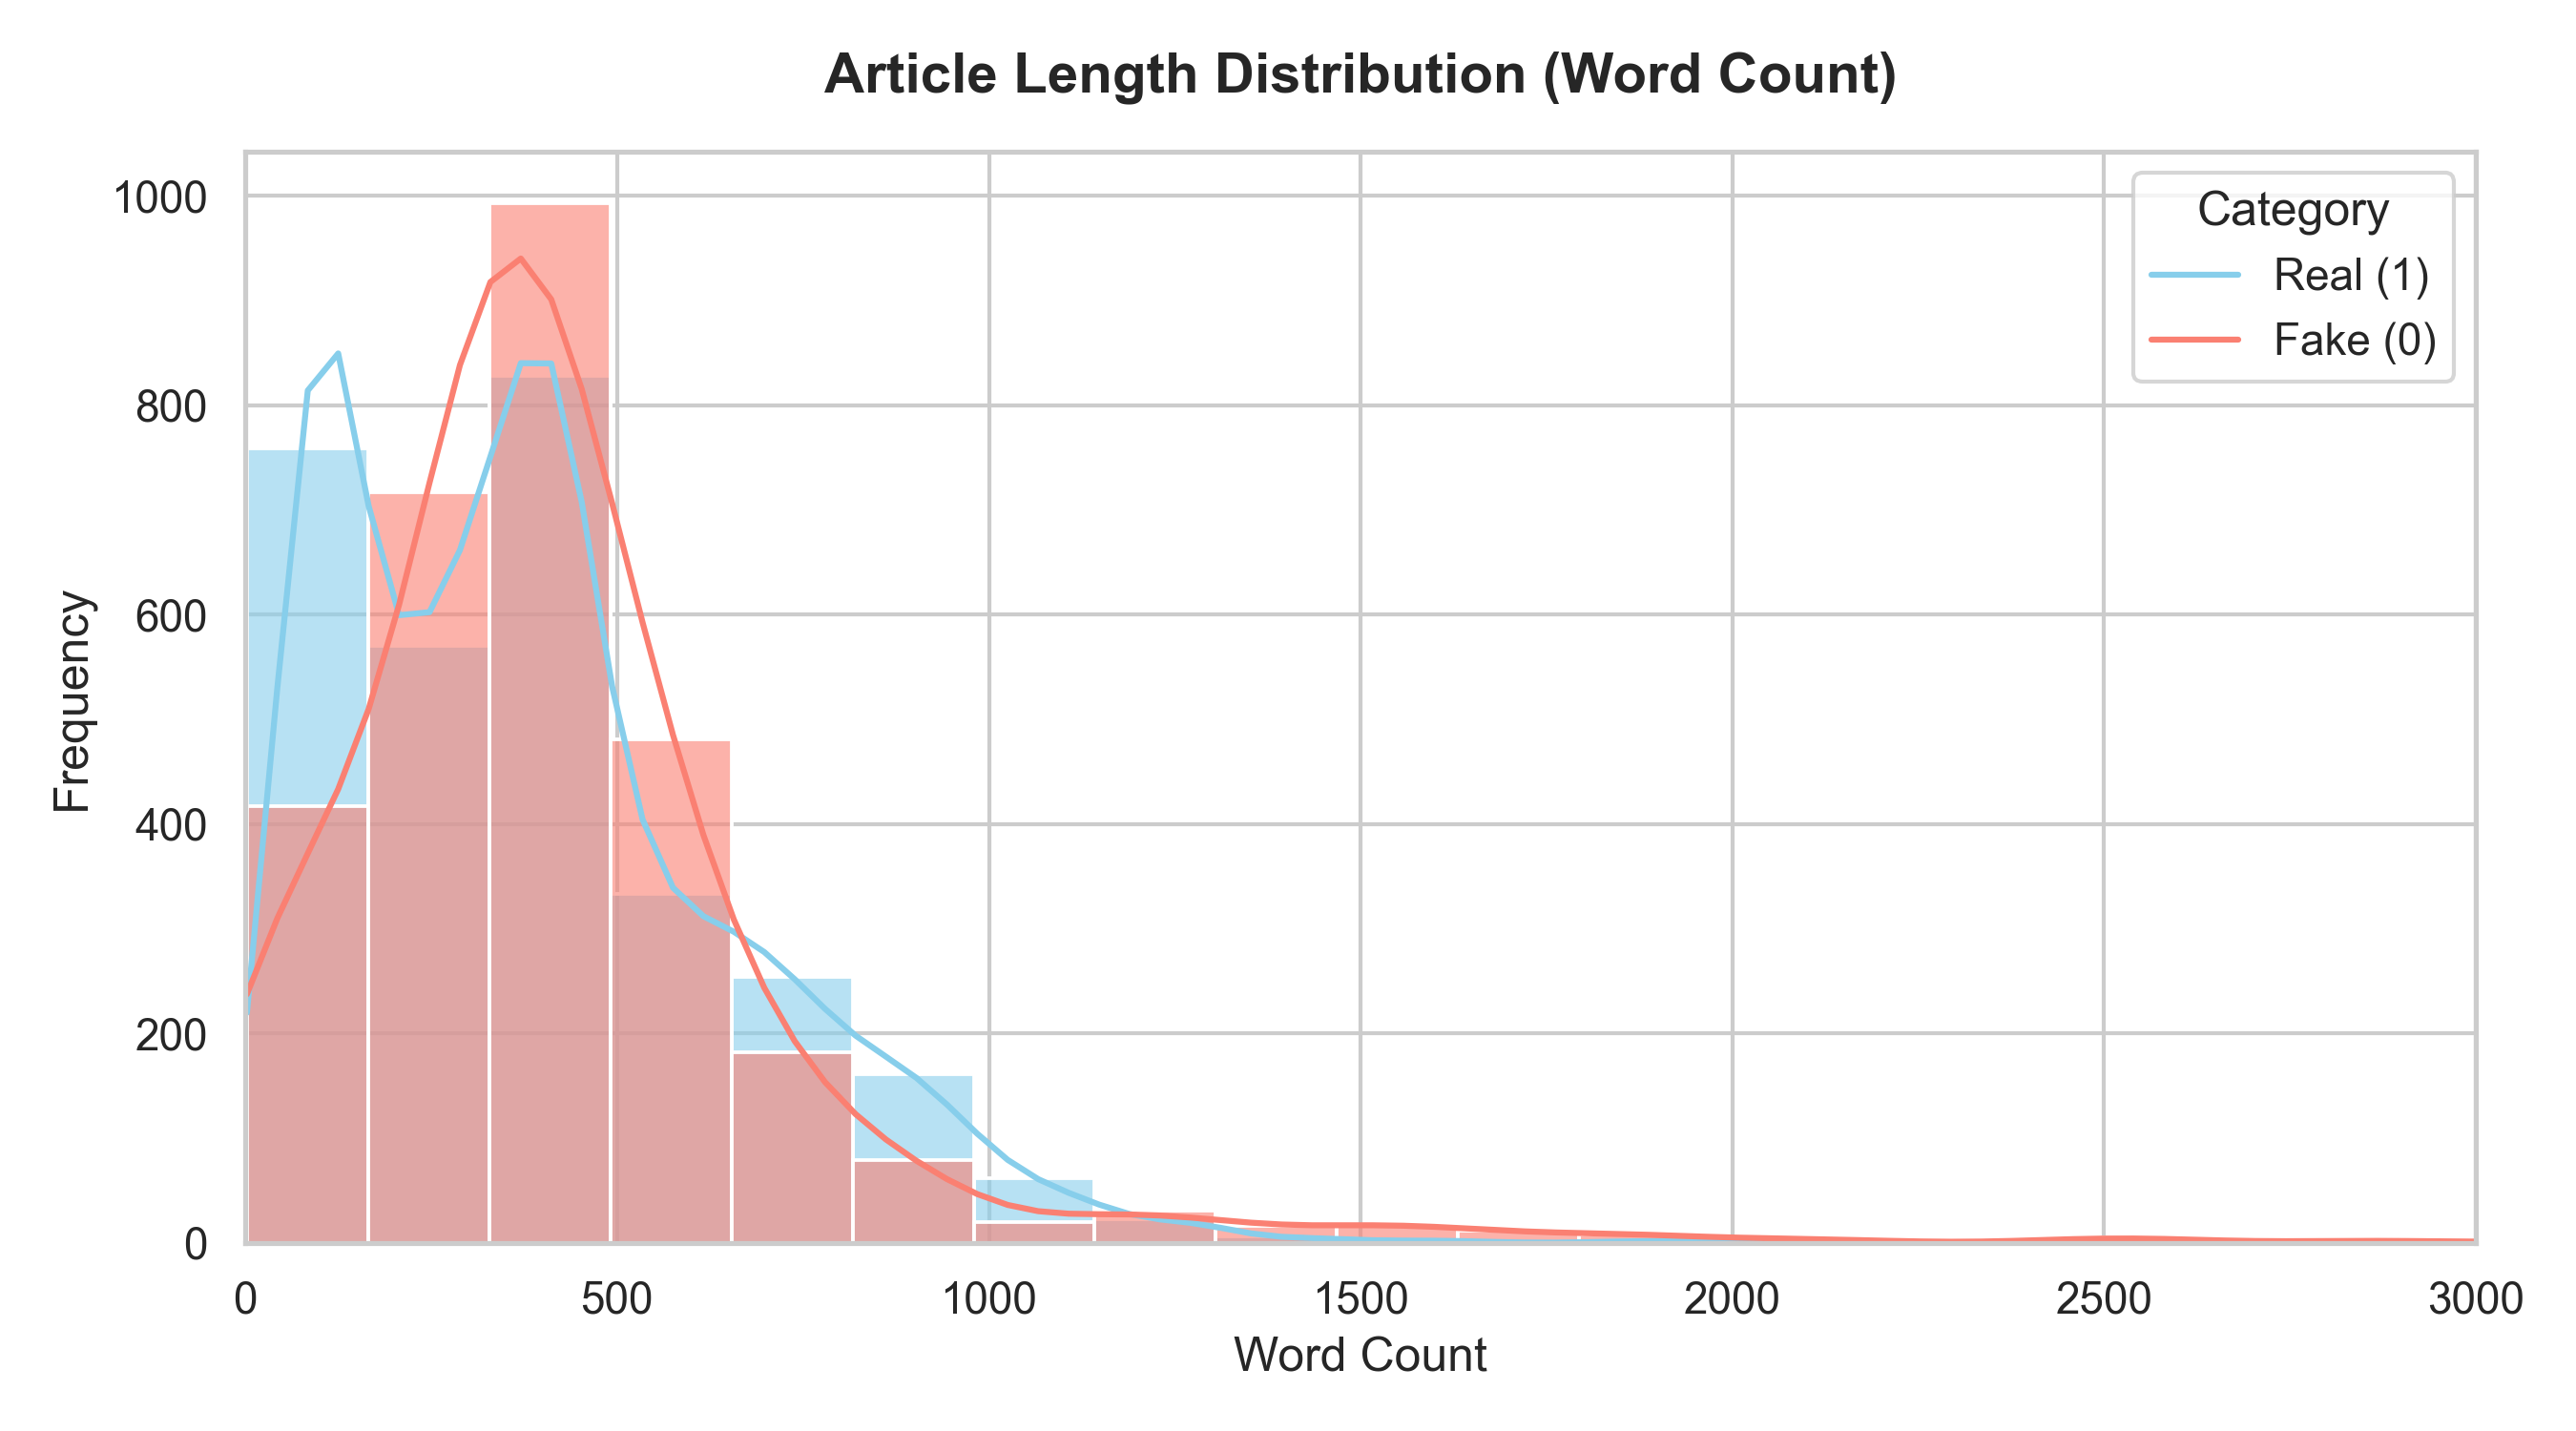
🖼️ word_count_distribution.png
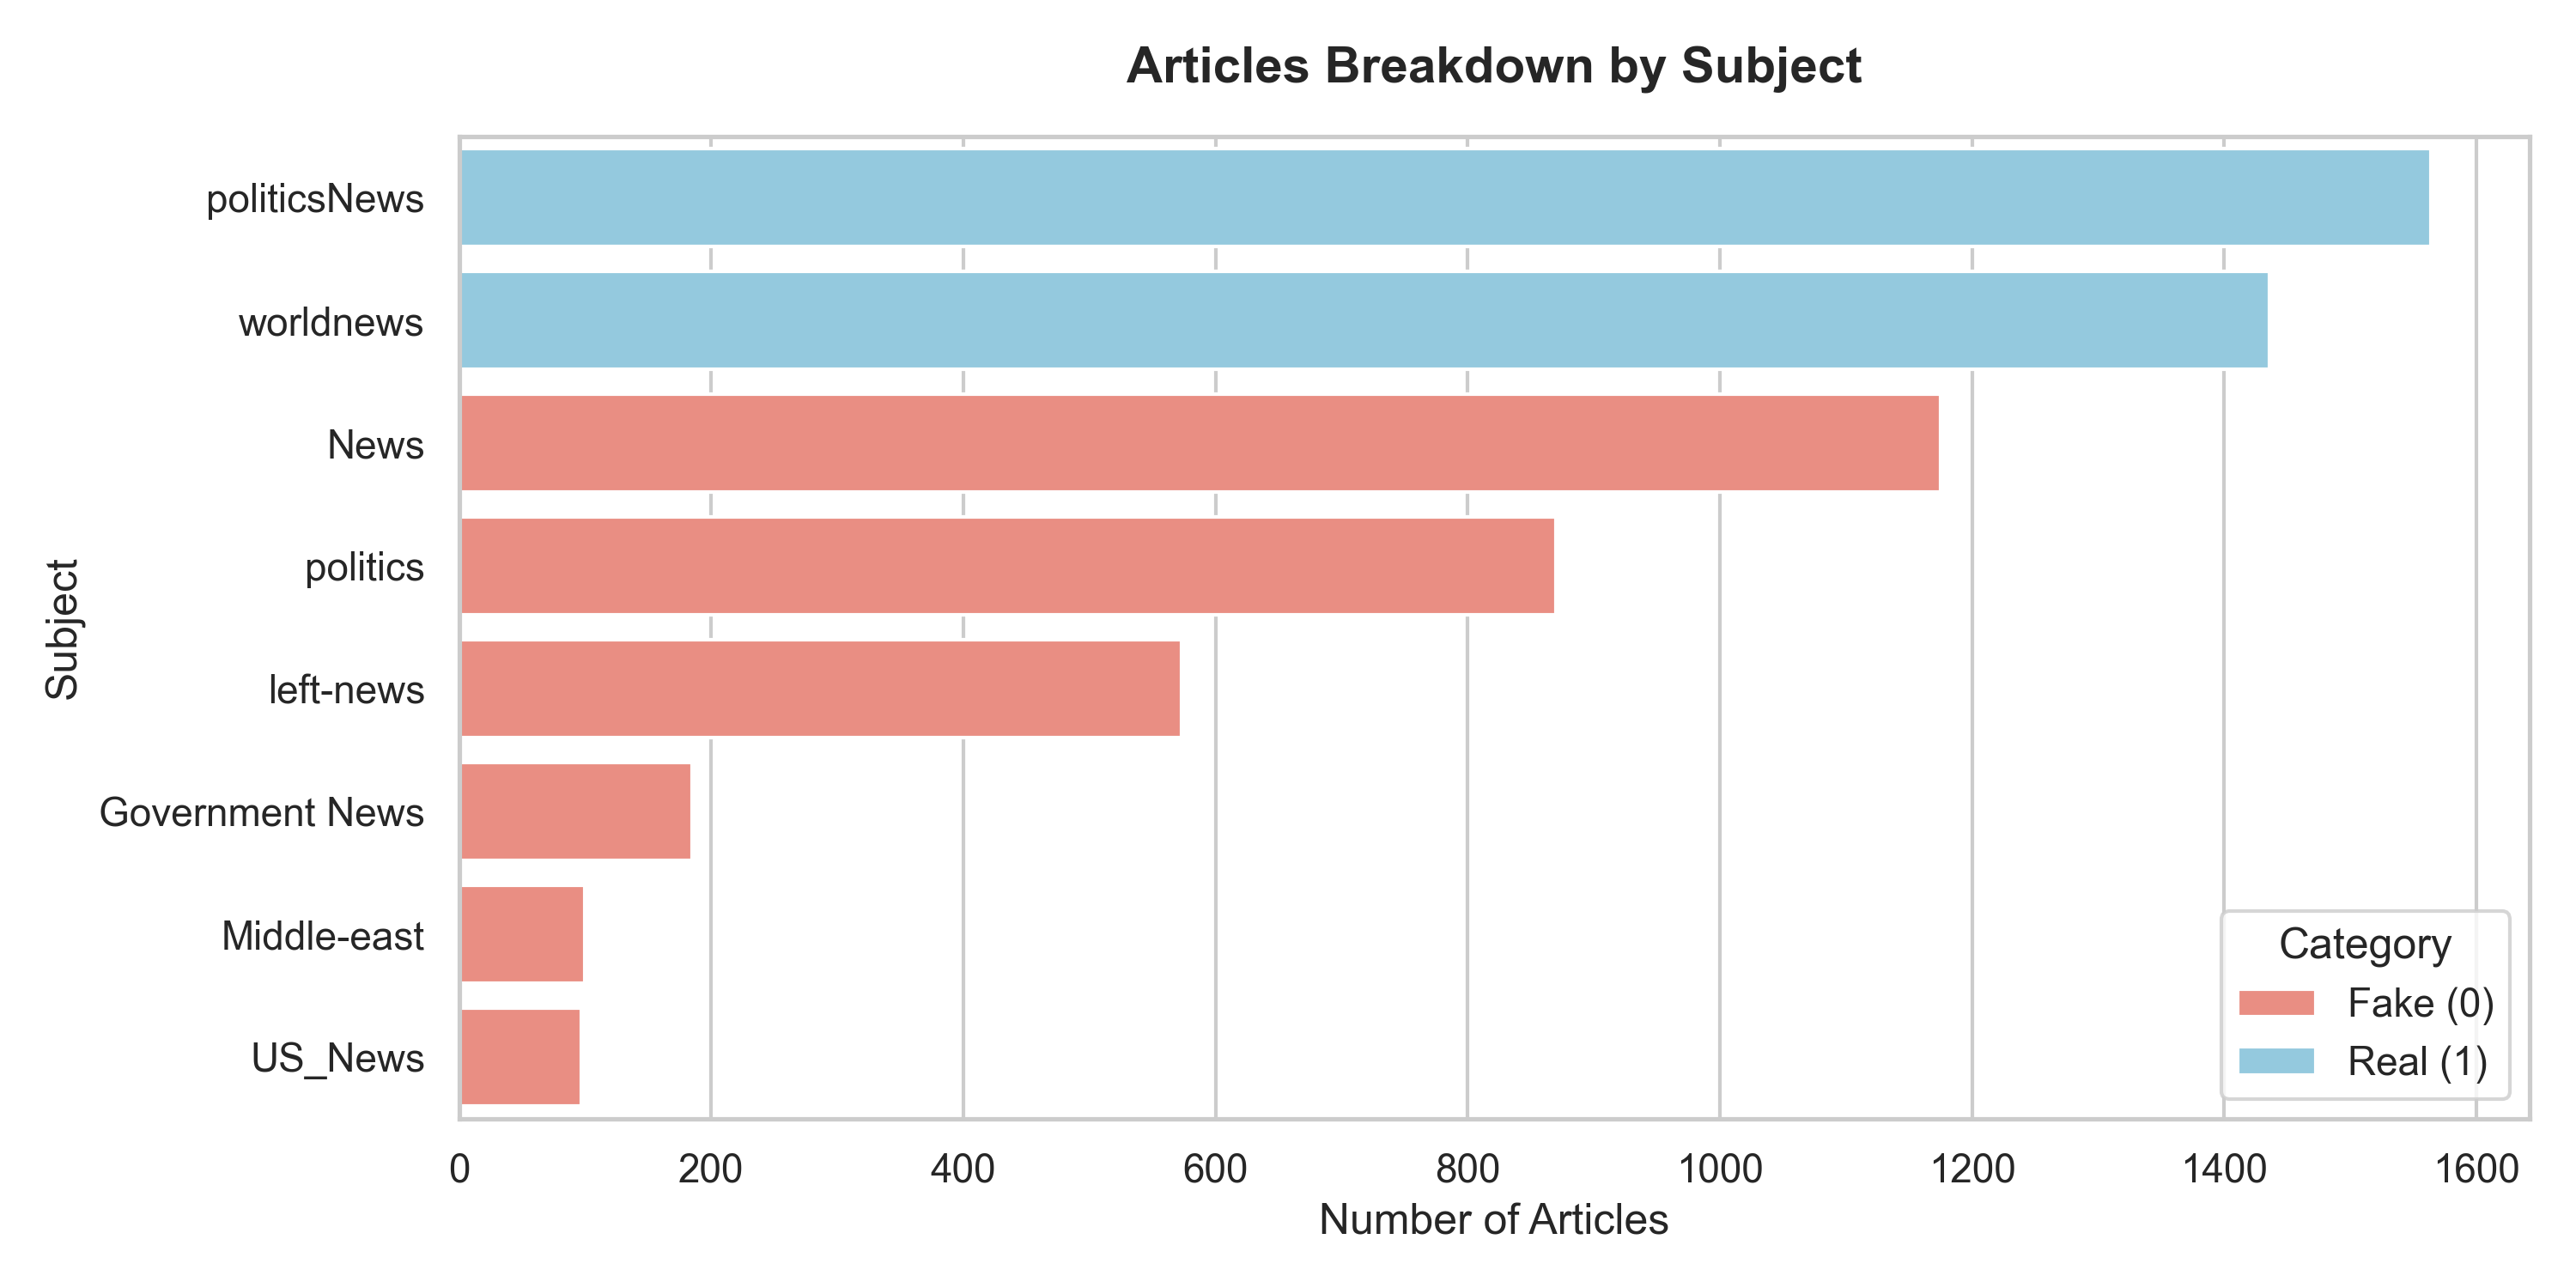
🖼️ subjects_breakdown.png
Fazit: Es ist unmöglich, den Wahrheitsgehalt einer Nachricht allein anhand ihrer Formulierung zuverlässig zu bestimmen. Ein vollfertiges System zur Erkennung von Falschmeldungen muss über Funktionen zur Faktenprüfung und zum Quellenvergleich verfügen.
Der Quellcode für fake_news_detector.py ist auf GitHub verfügbar. Schaut rein, testet es aus und teilt eure Gedanken!