Всем привет! Я решил попробовать освоить NLP (обработку естественного языка) и для стартового проекта нашёл датасет с выдуманными и настоящими новостями. Своей целью я поставил обучить модель отличать вбросы от реальных новостных публикаций.
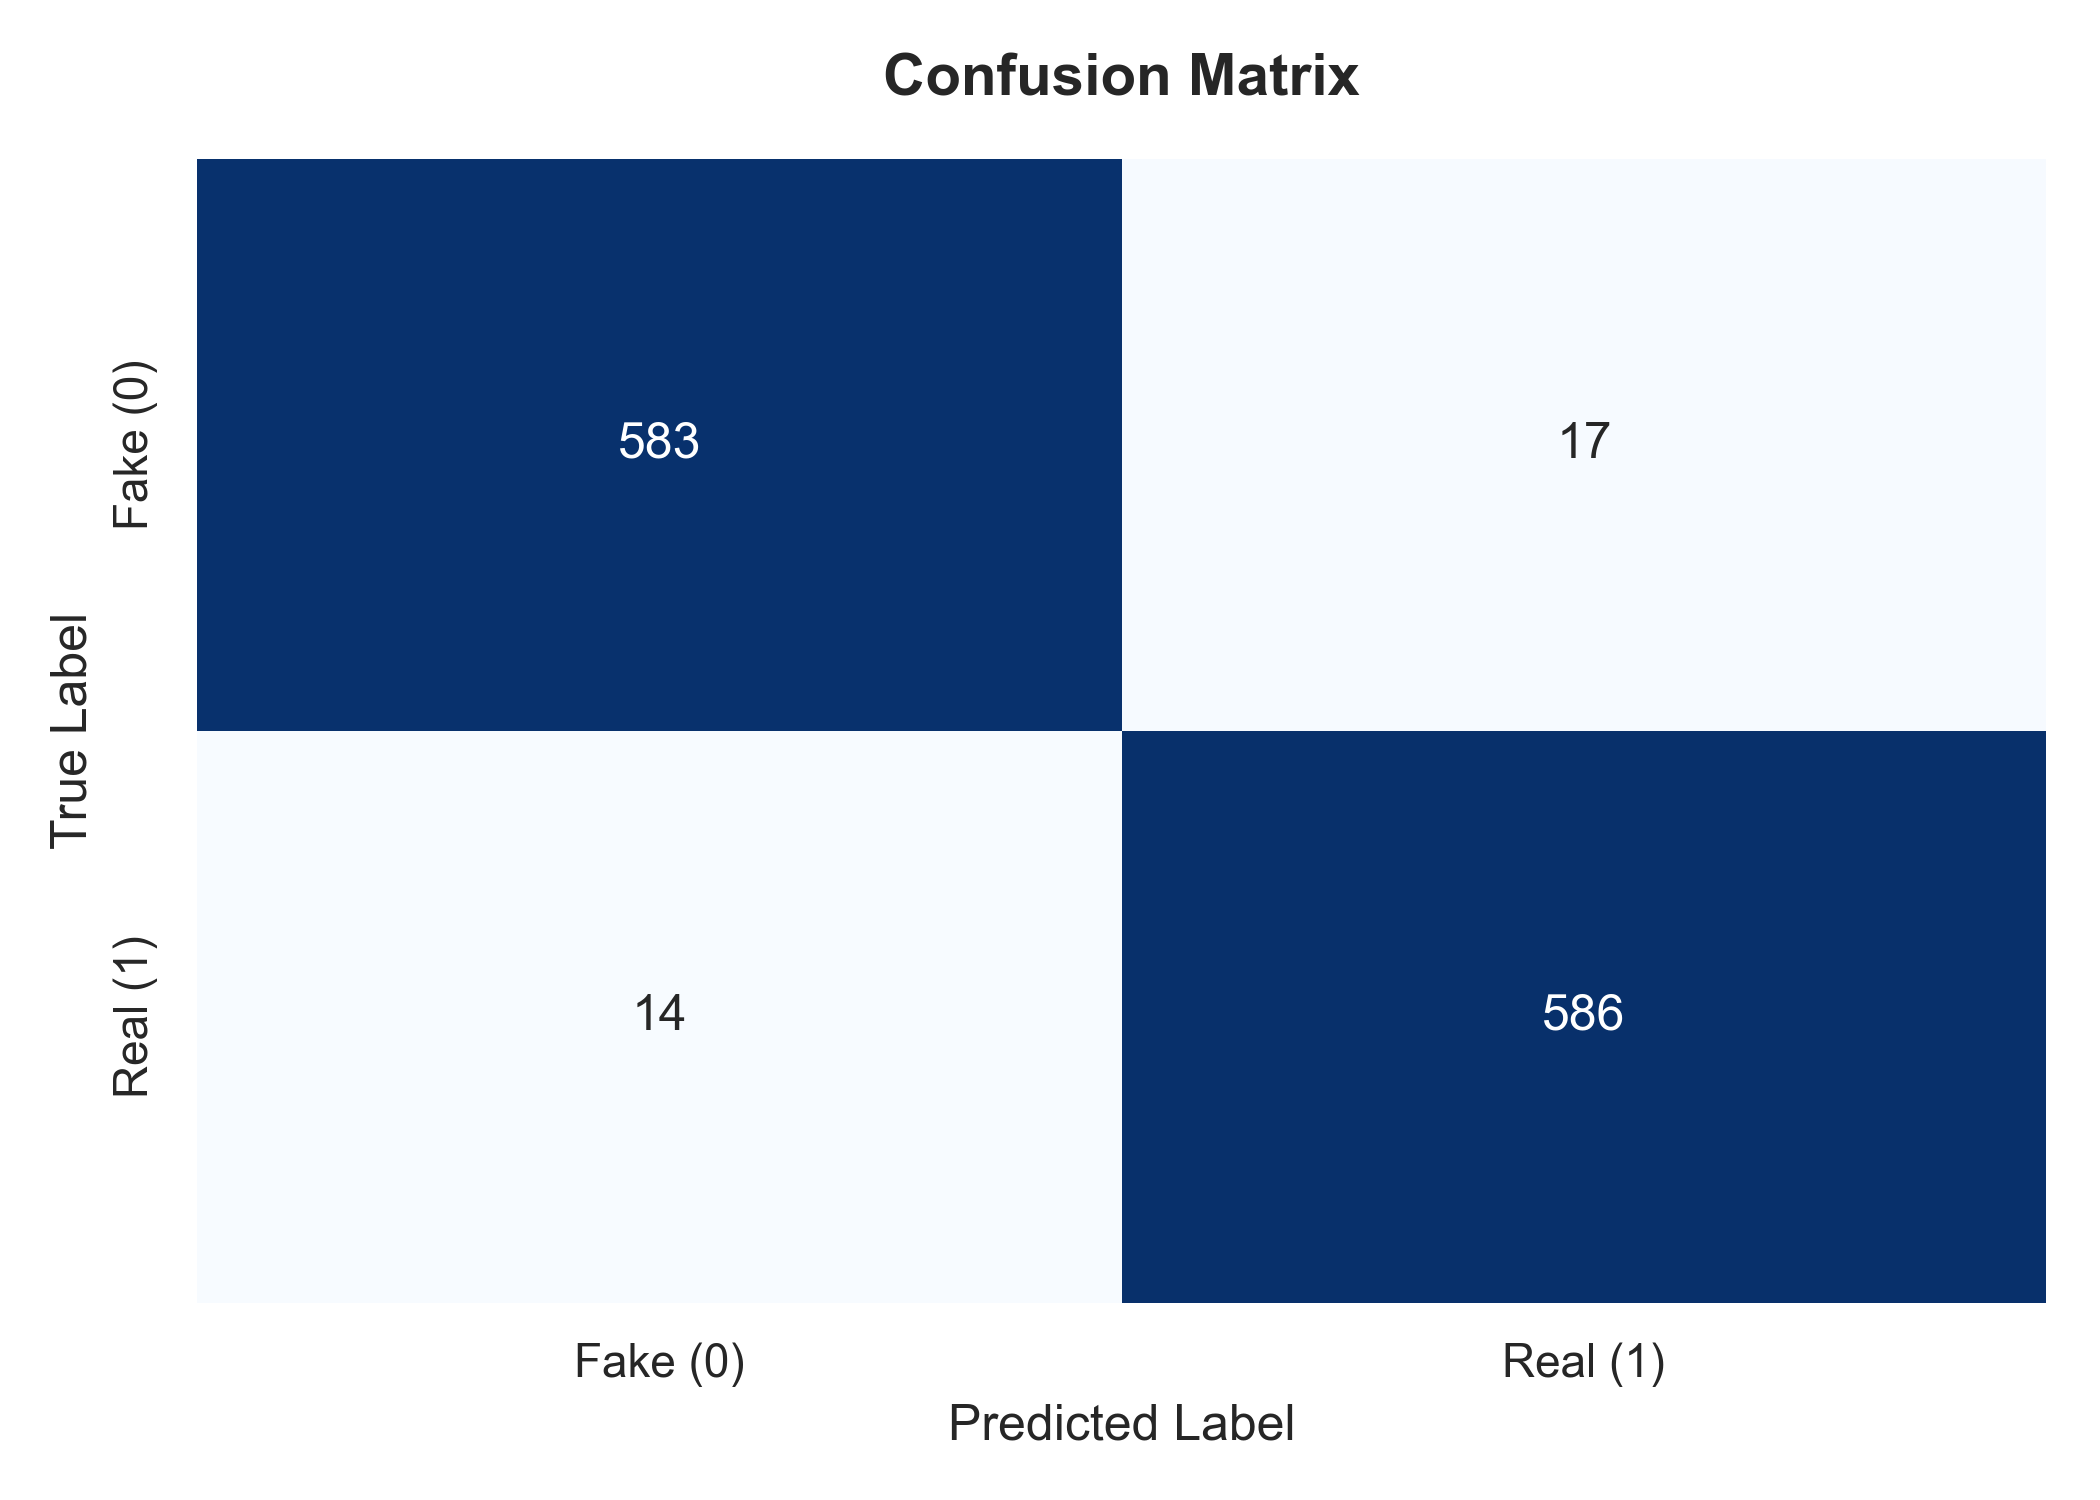
Для реализации я использовал связку TF-IDF Vectorizer и Logistic Regression из библиотеки scikit-learn. На отложенной тестовой выборке модель показала внушительные 97,25% точности. Однако самое интересное началось при проверке одной и той же выдуманной новости, сформулированной четырьмя разными способами:
“BREAKING: Germany Bans Smartphones in All Schools and Universities Starting 2027” → Real
“Germany to Introduce Nationwide Smartphone Ban in Schools and Universities in 2027” → Real
“Federal Government Announces New Restrictions on Smartphone Use Across German Education System” → Real
“Germany Plans to Eliminate Personal Smartphone Use in Educational Institutions Starting in 2027” → Fake
🖼️ confusion_matrix.png
Обратите внимание, что несмотря на высокий показатель accuracy (точности), модель ошибается. На её вердикт критически влияют состав слов и стиль написания:
«BREAKING» и «Nationwide» напоминают заголовки срочных новостных сводок.
«Federal Government Announces» звучит как официальный релиз.
«Plans to Eliminate» использует сочетание слов, чаще встречающееся в фейковых примерах из обучающей выборки.
Из-за этого классификатор оценивает лишь стиль и сочетания слов, совершенно упуская манипуляции фактами, числами или датами.
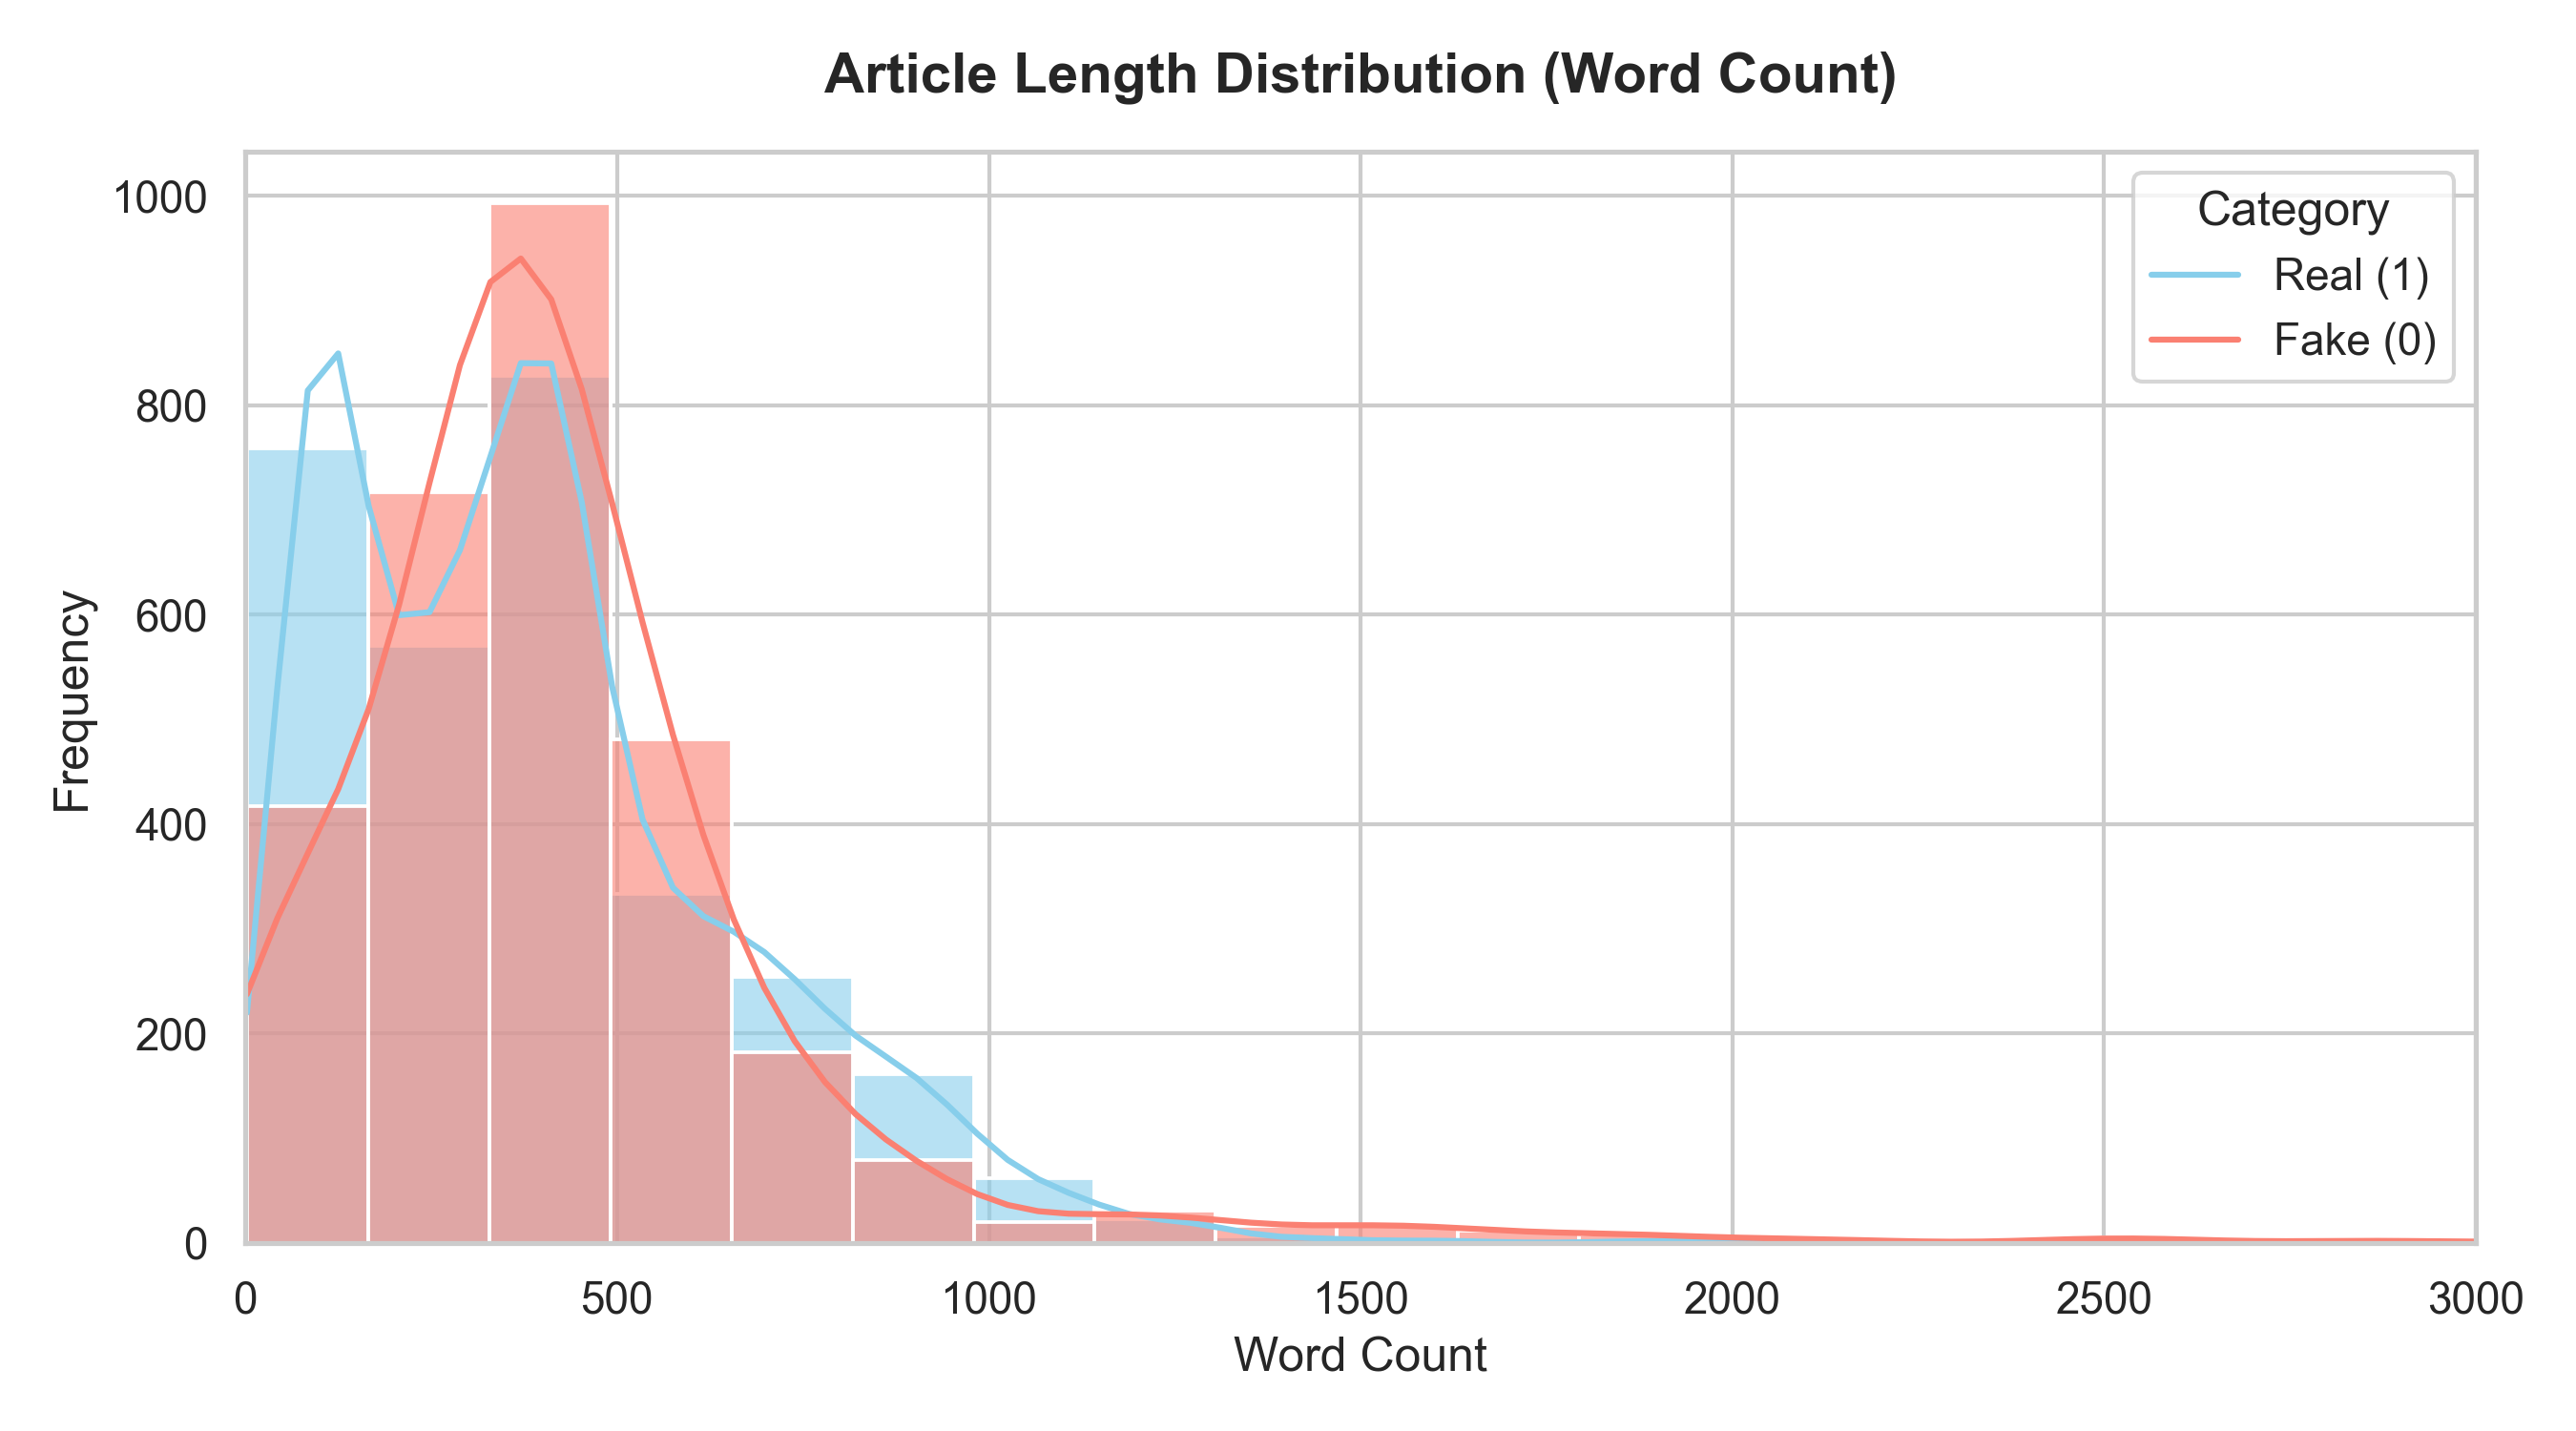
🖼️ word_count_distribution.png
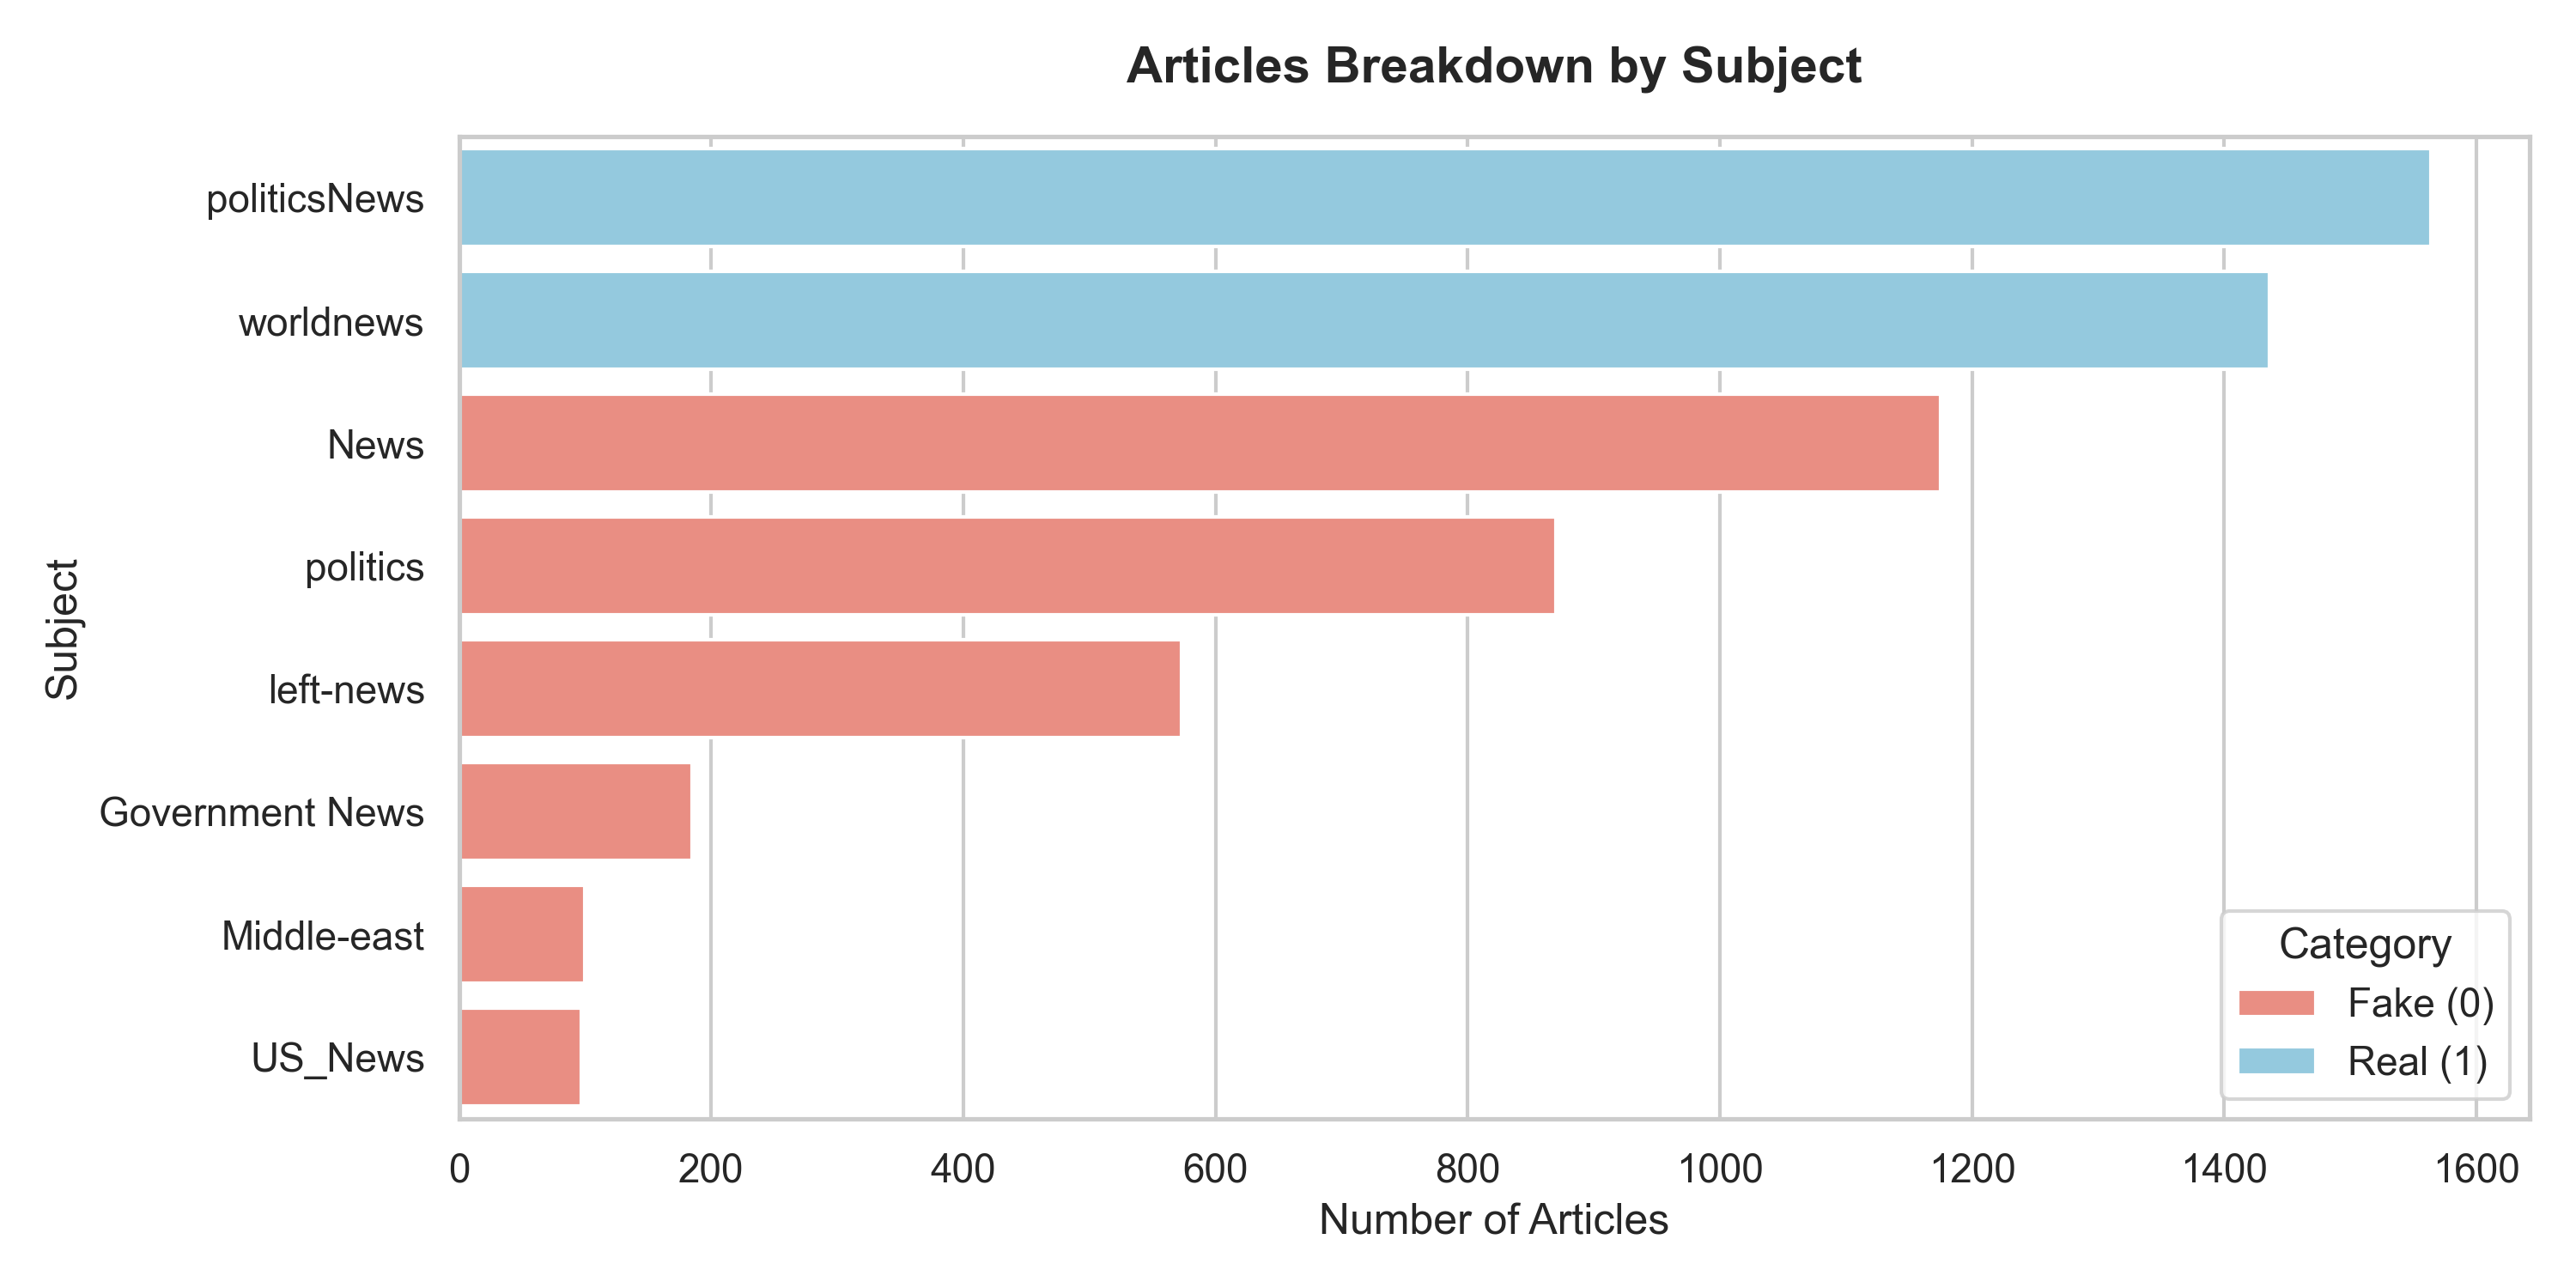
🖼️ subjects_breakdown.png
В итоге можно сказать, что невозможно достоверно определить правдивость новости только по её формулировке. Полноценная система обнаружения фейков должна обладать возможностью фактчекинга и сопоставления источников.
Исходный код скрипта fake_news_detector.py выложен на GitHub. Заходите, тестируйте и делитесь мнением!